Rust ownership
Por Arrecio
Comenzamos diciendo que Rust es un lenguaje excelentemente documentado. Su libro digital El lenguaje de programación Rust esta públicamente disponible en multiples idiomas y en lo que respecta al tema que nos ocupa este se trata el capítulo Entendiendo el Ownership. Otras fuentes interesantes, aunque no tan traducidas, son el libro de cargo que es el manejador de paquetes de Rust, y también la documentación de sus librerías.
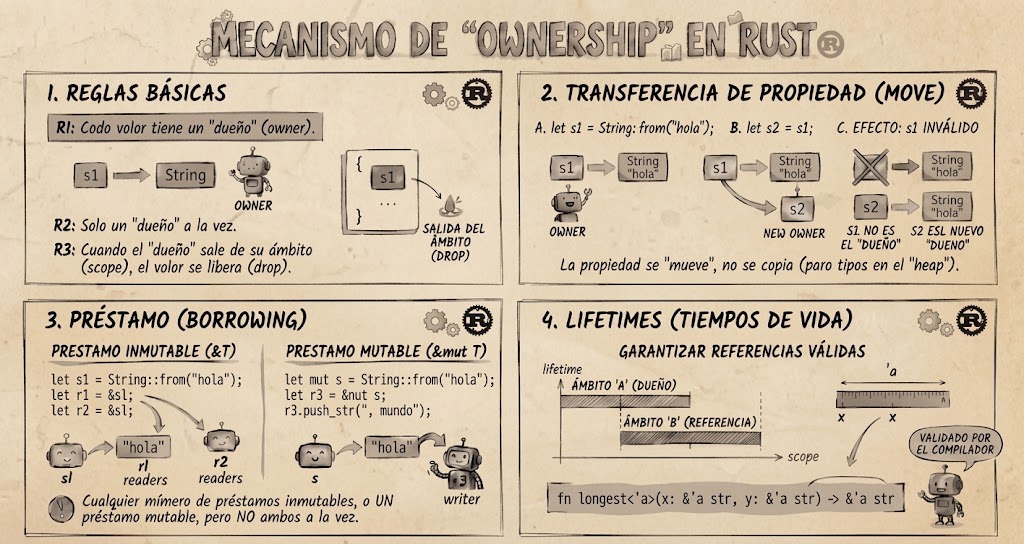
Ya por mi parte aporto esta ilustración que resume bastante bien en que consiste:
Momento de recordar ahora la forma con la que en C++ moderno tratamos de luchar contra las fatídicas fugas de memoria: los C++ smart pointers. Este se trata de un mecanismo que funciona en tiempo de ejecución siendo aún propenso a descuidos siendo el programador el responsable de su buen uso. Otros lenguajes encaran este problema mediante un sistema de recolección de basura lo que prácticamente convierte cada variable en una referencia a un lugar de la memoria y que lleva implicita un contador. Por simplificar, el recolector de basura es un subproceso, hilo o similar que regularmente comprueba el número de referencias y cuando esta llega a 0 es cuando la memoria se libera.
En lo que a Rust respecta, su lucha contra las fugas de memoria comienza en tiempo de compilación mediante el respeto a unas reglas muy estrictas que aunque pueda parecer que esto limita las capacidades del lenguaje no lo hace una vez que técnicamente no hablamos de lo mismo, existiendo también los Rust smart pointers.
La ventaja de esta estrategia es que además se evita que se ejecuten ciertas comprobaciones en tiempo de ejecución eliminando así cierto overhead mejorando el rendimiento, especialmente frente a los lenguajes de recolección de basura. Dicho esto queda claro que Rust no es uno de estos lenguajes. Además el sistema de Ownership garantiza que tras cada referencia exista un objeto válido, otra gran ventaja.
Reglas de Ownership
Momento para hablar de las reglas que como hemos dicho no se tratan únicamente de una relación de buenas prácticas sino que se trata de un conjunto de principios de estricto cumplimiento si pretendemos que nuestro programa compile.
Rust como otros muchos lenguajes entiende de ámbitos de ejecución también conocidos como contextos o como scopes por su nombre en inglés. El primer párrafo de la entrada en la Wikipedia es suficientemente explicativo: En programación de computadoras, el ámbito (del inglés scope) es el contexto en el que las variables y expresiones son visibles para ser utilizadas dentro del código.
El concepto de ámbito de ejecución es especialmente útil en tiempo de compilación, ayudando a los programadores a no producir código que provoque daños colaterales indeseados. Veamos el ejemplo ilustrativo que usan en el manual de Rust:
    {                      // s no es valido aquí, aún no está declarado
        let s = "hola";   // s es valido desde aquí

        // Hacer algo con s
    }                      // este ámbito termina aquí, s ya no es valido
El manual de rust introduce diversos conceptos previos antes de describir el procedimiento del Ownership, entre ellos los conceptos de Stack o Pila y Heap o Montón. Aunque los enlaces llevan a unas entradas de la Wikipedia referidas a estructuras de datos en realidad se refiere a dos lugares en los que alojar datos en la memoria. La memoria del equipo es físicamente un único bloque dividido en bloques lógicos. Los sistemas operativos la administran a bajo nivel pero los programas de usuario pueden tambien implementar sus propios manejadores. La administración mediante Pila y Montón es el sistema de administración histórica de memoria y si el lector no está familiarizado con estos conceptos un buen lugar para consultar es Stack vs Heap Memory Allocation.
La gestión de memoria de la Pila resulta bastante sencilla. Cuando el programa entre en un nuevo ámbito se registra el lugar en el que se encuentra el puntero a la cabeza de la pila. Las variables necesarias en ese ámbito van ocupando lugar en la Pila, cuando se sale del ámbito se restaura el puntero a lugar que ocupaba en su entrada. No es necesario hacer nada con la memoria utilizada por las variables, y de hecho siguen estándo en tal memoria tan sólo que es espacio que ya se considera inválido dentro de la Pila.
Respecto a lo dicho en el párrafo anterior, si alguna de las variables contiene datos de tamaño dinámico estos datos no pueden meterse en la Pila ya que cuando otra variable se apile sobre la primera impedirá que pueda ampliarse la memoria al valor que necesita. En estos casos lo que se incorpora a la Pila es un puntero al lugar de la Memoria del montón en el que residen realmente los datos, ese lugar debe previamente reservarse para el uso exclusivo de tal variable. He aquí el origen de las fugas de memoria. Cuando el programa sale de cierto contexto restaura el puntero de la Pila y los datos apilados durante el ámbito son descartados. Si entre esos datos existen punteros a lugares del Montón que no han sido recuperados mediante la liberación de la memoria entonces estamos ante una fuga de memoria de la que difícilmente nos podremos recuperar.
Los punteros inteligentes de C++ hacen este trabajo por el programador. std::unique_ptr, por ejemplo, tiene un tamaño conocido por lo que se almacena enteramente en la Pila conteniendo el puntero al lugar del Montón donde se almacena el dato principal. Un programa en C++ se encarga de que antes de que se restaure el puntero de la Pila todos los objetos contenidos en la misma son debidamente "destruidos" lo que conlleva la ejecución de cierta rutina llamada destructor y cuya finalidad es, entre otra, la de liberar la memoria dinámica utilizada por sus atributos. Los punteros inteligentes deciden mediante su cuidado destructor si al salir del ámbito debe liberarse o no la memoria en el Montón a la que apunta el puntero al objeto real que manejan.
El mecanismo de Ownership trabaja también sobre el Montón y específicamente con objetos. Por defecto todos los objetos dinámicos contenidos, o más bien inicializados dentro de un ámbito son liberados al salir del mismo debiendo utilizar obligatoriamente una serie de operaciones específicas para poder conservar los datos y seguir utilizándolos fuera del contexto. Aquí más sobre destructores en Rust y aquí más en concreto para su método Drop.
Este simple compartamiento se traduce en las reglas básicas del Ownership que estando reflejadas en el punto 1 del diagrama se reunen en una única frase: "Cada objeto tiene uno y sólo un dueño que libera el sus datos cuando la ejecución abandona su ámbito".
Transferencia de propiedad de objetos
Para asegurar que un dato dato tipo objeto únicamente contenga un dueño (Owner) el comportamiento del lenguaje difiere de otros. Cuando se asigna una variable con el valor de un objeto recién creado tal variable se convierte en el dueño del objeto. Si se asigna esa variable a cualquier otra se produce la transferencia de propiedad y la primera variable pasa a un estado inválido. La realidad es que si lo piensas rara vez se pude necesitar dar dos nombres a una misma variable. Esta es una regla cuyo cumplimiento se asegura en tiempo de compilación por lo que el siguiente código dara error al compilar:
fn main() {
    let s1 = String::from("hola");  // s1 es el dueño el objeto String con el valor de "hola"
    let s2 = s1;                    // objeto transferido, s1 pasa a un estado inválido

    println!("{s1}, mundo!");       // error de compilación
}
Como se observa la operación de transferencia o move se realiza con el operador =(igual) pero sólo cuando se aplica con objetos. Cuando se aplica a variables de tipo primitivo (y tuplas de estos), diseñados para alojarse enteramente en la Pila, se realiza una copia bit a bit, si es que esta está permitida (ver el modificador mut de mutable).
Animo al lector a probar el código en [play.rust-lang.org] y analizar el mensaje de error. El mismo incluye un mensaje indicando que el operador igual ha movido la propiedad, algo que podría haberse evitado implementado el Copy trait, algo que no es objeto de este texto pero con lo que se infiere que la operación de transferencia puede evitarse implementando ese "trait" que en este contexto se refiere a una característica del tipo de objeto.
Pero existe otra forma de transmisión de propiedad y esta es a través del paso a una función como argumento.
Ya hemos dicho que las reglas de Rust son muy estrictas y cuando un objeto se utiliza como argumento de una función ese parámetro pasa a ser el dueño del objeto. El siguiente código también dará un error:
fn main(){
    let s1 = String::from("hola");
    test(s1);                       // objeto transferido

    println!("{s1}, mundo!");
}

fn test(s2: String){                // s2 pasa a ser el dueño del objeto
    println!("{s2}, mundo!");
}
El error vuelve a advertir, lógicamente, de que s1 no implementa Copy y por tanto es movido, lo que termina deviniendo en error. Resulta evidente que este error no se produce cuando utilizamos variables que contienen datos primitivos los cuales implementan implicitamente esa característica.
No obstante podemos evitar el error si transferimos de vuelta la propiedad lo que cual se puede realizar colocando la variable que ostenta la propiedad al final de la función:
fn main(){
    let s1 = String::from("hola");
    let s3 = test(s1);

    println!("{s3}, mundo!");
}

fn test(s2: String) -> String {
    println!("{s2}, mundo!");
    s2
}
Referencias (o borrowing en Rust)
Lo visto hasta ahora puede aparentar que resta al lenguaje de funcionalidad al estar sujeto a las ferreas reglas de propiedad. No obstante Rust permite el uso de referencias como alternativa. Al igual que en C++ se utiliza el símbolo & (ampersands) para declarar que la variable o el argumento debe tratarse como una referencia.
Una referencia es un puntero puro. La expresión let s1 = String::from("hola") convierte a s1 en una variable tipo String que contiene al menos 3 campos de tamaño conocido como son uno que almacena un valor entero referido a su longitud, otro a su capacidad máxima, y luego un valor tipo puntero al lugar de la memoria en la que se aloja la cadena. Los campos se almacenan en la Pila, la cadena en sí en el Montón. Las referencias se almacenan igualmente el Stack. El siguiente ejemplo ilustra el uso de referencias, el cual compila sin problemas:
fn main(){
    let s1 = String::from("hola");
    test(&s1);
    let s3 = &s1;

    println!("{s1}, mundo!");
    println!("{s3}, mundo!");
}

fn test(s2: &String) {
    println!("{s2}, mundo!");
}
Como a la gente de Rust le gusta usar su propia nomenclatura al sistema de referencias se le conoce como Borrowing de prestar en ingles.
Aunque el uso de Borrowing puede verse como un método para burlar el sistema de Ownership, y en parte lo es, Rust no ofrece total libertad con ello. El Borrowing se permite a sabiendas de que Ownsership es claramente restrictivo en muchos supuestos simples. Párrafos atrás justificaba el Ownership diciendo "La realidad es que si lo piensas rara vez se pude necesitar dar dos nombres a una misma variable" pero raramente no quiere decir nunca. Borrowing implementa esa excepción pero para que la cosa no se nos vaya de las manos (especialmente trabajando con multi-hilo) permite únicamente una referencia mutable activa para cada variable. Además, si existe una referencia mutable no puede existir ningún otro tipo de referencia a la misma variable. No obstante si no existen referencias mutables se pueden manejar cuantas referencias inmutables queramos, esto difícilmente puede acarrear problemas. Esto asegura que cuando se utilice un dato este siempre tendrá un estado válido.
Por supuesto las referencias son sólo válidas mientras no se salga del contexto en el que reside el dueño real de la misma lo cual puede ser advertido en tiempo de compilación una vez que tanto dueño real como referencias forman parte del mismo contexto. Una referencia no puede crearse sin que exista la variable referenciada y esto implica que se incrusta en la misma ventana de la Pila y desaparece del contexto a la misma vez por lo que el compilador hace esto trivialmente en estos casos. Sin embargo debe observar casos como el del siguiente código, impidiendo que la referencia pueda cambiar de contexto:
fn main() {
    let s = test();
}

fn test() -> &String {
    let s = String::from("hola");

    &s
}
El tipo Slice
Siguiendo el manual toca hablar de los Slices cuya traducción literal es rebanada. Los Slices son referencias a porciones de colecciones y no al objeto completo. Lógicamente únicamente operan con objetos de tipo colección (enumerables e indexables). Entre estos tipos están las cadenas o String las cuales son vistas como colecciones de caracteres.
Respecto a los slices hay que tener en cuenta que no contienen datos en sí, son efectivamente referencias. Contienen una dirección que apunta al caracter más a la izquierda en el objeto del cual se ha creado el slice así como la longitud del slice. Por tanto mientras exista un slice de una colección, que no deja de ser una referencia inmutable, no se podrá modificar el objeto inicial ya que para poder hacer esto hay que utilizar funciones que requieren de una referencia mutable del mismo, lo cual provocará error en tiempo de compilación no se podrá modificar el objeto inicial ya que para poder hacer esto hay que utilizar funciones que requieren de una referencia mutable del mismo, lo cual provocará error en tiempo de compilación.
El manual de Rust incluye el siguiente ejemplo para ilustrar esto:
fn first_word(s: &String) -> &str {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return &s[0..i];
        }
    }

    &s[..]
}

fn main() {
    let mut s = String::from("hello world");

    let word = first_word(&s);

    s.clear(); // error!

    println!("the first word is: {word}");
}
En el ejemplo first_word devuelve un slice que técnicamente es una referencia inmutable. La función clear requiere de una referencia mutable del propio objeto lo que deviene en error ya que no es posible tener referencias mutables coexistiendo con referencias inmutables. Esto son situaciones que pueden preverse durante la compilación lo que hace de Rust un lenguaje especialmente resistente a errores en materia de corrupción de datos, los más temidos en lenguajes como C y C++.